Showing posts with label 確率統計. Show all posts

Apr 6, 2023

Exclusive Form

日本の中高数学の教科書では,frequency distribution table(度数分布表)を作成するときに,class(階級)の interval(区間)を ”at least / less than(以上/未満)" で表すのが普通ですが,英語のテキストを見ると,離散的な(連続でない)値はほぼ "at least / at most(以上/以下)" で表されています.例えば,100点満点の試験で60点台を表すのに,日本では「60以上70未満」で表すことが多いですが,英語のテキストでは「60以上69以下」という表し方が多く見られます.

そのため,アメリカの Microsoft社の表計算ソフト "Excel" の FREQUENCY(階級ごとに度数を返す)関数は、度数を「以上/以下」で数えますから,「以上/未満」でデータを数えたい場合は、FREQUENCY関数ではなくCOUNTIFS関数を使って度数を数えることになります.

英語ではこれらの表し方には名前がついていて,「以上/未満」の場合は "Exclusive Form (or Continuous Form)",「以上/以下」の場合は "Inclusive Form (or Discontinuous Form)" と呼ばれています.直訳すると,「除外型」と「包含型」になりそうですが,日本語のテキストではこれらの用語が使われているのを見たことがありません.次の英文はその解説のひとつです.

There are two methods of classifying data according to the class intervals.
1) Exclusive Form (or Continuous Form):
When the class intervals are so formed that the upper limit of one class is the lower limit of the next class it is known as exclusive form. In this form, the upper limit of a class is not included in the class. Thus, in class 0-10, the value 10 is not included. It is counted in the next class 10-20.
2) Inclusive Form (or Discontinuous Form):
The classes are so formed that the upper limit of a class is included in that class. In class 1-10, the values lie between 1 and 10, including both 1 and 10. 

(CK-12.org)

いくつかの英語の本やサイトで,inclusive form をexclusive formに変換するのに,ひとつの階級の上限と次の階級の下限との差を2で割ったものを,全階級の下限から引き,全階級の上限に加えるという方法…①が紹介されています.例えば下図左の59と60との差 1 を2で割ると0.5なので,全階級の下限から0.5を引き,全階級の上限に0.5を加えます.すると下図右のような「以上/未満」型のexclusive formになります.

しかし,次のようにひとつの階級の上限と次の階級の下限との差を,全階級の上限に加える方法…②もあります.例えば下図左の59と60との差は 1 なので,全階級の上限に 1 を加えます.このほうが整数の「以上/未満」型 exclusive formに慣れている人には分かり易いかもしれません.


①は小数第 1 位で四捨五入して整数にしてから階級分けをすることと同じで,②は四捨五入せず小数のままで階級分けすることと同じです.例えば59.8は,①では上から2つ目,②では一番上の階級に入ることになります.

[Reference]

CK-12 : Classification of Data and Frequency Distribution - Definition, Methods, Steps and Examples
https://flexbooks.ck12.org/cbook/ck-12-cbse-maths-class-8/section/14.1/primary/lesson/classification-and-tabulation-of-data/

Class Interval
https://byjus.com/question-answer/convert-the-given-class-intervals-in-exclusive-form/

Office Hack : ExcelのFREQUENCY関数の使い方|データの度数分布を垂直配列で返す
https://office-hack.com/excel/frequency/

Mar 13, 2022

Bin

缶は英語でも can といいますが,瓶は bin ではなく bottle といいます.bin には蓋つきの容器やごみ箱という意味があるので「物を入れる」という点では瓶と似ています.さらにこの bin には数学用語でも2つの意味があります.

■binary(2進法)

decimal(10進法)は,ある数を0から9までの整数10個を係数に使って10の冪(べき)の和で表したとき,その係数を並べて表します.例えば234は,$$\begin{align} 200+30+4&=2\times10^2+3\times10^1+4\times10^0\\&=234\end{align}$$一方, binary(2進法)は,ある数を0と1のみを係数に使って2の冪の和で表したとき,その係数を並べて表します.例えば10進法の 234 は,$$\begin{align} 234&= 128+64+32+8+2\\ &= 2^7+2^6+2^5+2^3+2^1\\&=1\times2^7+1\times2^6+1\times2^5+0\times2^4+1\times2^30\times2^2+1\times2^1+0\times2^0\\&= 11101010_{(2)}\end{align}$$となり,2進法では$11101010_{(2)}$と表されます.

因みに,ファイルの拡張子で".bin"というのがありますが,テキストファイル".txt"以外のファイル,すなわち binary file のことで,2進数で表現されています.

■frequency distribution table(度数分布表)の class(階級)

frequency distribution table の class のことを bin ともいい,ある区間ごとに分類された小グループのひとつひとつ(histogram の各棒)を意味します.data binning とは、全データをいくつかの bin に分けることをいい,data bucketing ともいいます.data を分けて容器またはバケツに入れるというイメージでしょう.したがって,histogram を作ることも data binning のひとつといえます. 

# of data(データの数)を $n$ とし,それらを $x_1, x_2, ...., x_n$とします.すると,# of bins(階級の数)$k$ と bin width(階級の幅)$h$ との関係は次式で与えることができます.$$k=\frac{\max x_i-\min x_i}{h}\tag{1}$$または$$h=\frac{\max x_i-\min x_i}{k}\tag{2}$$つまり,$k$と$h$はデータの範囲を比例定数とする反比例の関係になります(値が整数にならない場合は切り上げます).

例えば,ある100点満点の試験を27名が受験した結果が次の値だったとしましょう.
76, 57, 47, 100, 47, 55, 83, 57, 49, 68, 73, 55, 68, 87, 91, 89, 37, 72, 63, 62, 57, 30, 77, 25, 60, 12, 66


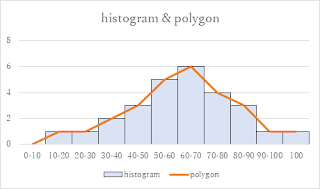
$k$=10を上の式(2)に当てはめると,$$h=\frac{100-0}{10}=10$$すると$k$=10のとき$h$=10になり,frequency distribution table と graph は上図のようになります.しかし,特にこの値にしなければならないわけではありません.$$\frac{100-0}{5}=20$$なので,$k$=5のとき$h$=20,$k$=20のとき$h$=5になります.また,$$\left\lceil\frac{100-0}{7}\right\rceil=\left\lceil14.2857....\right\rceil=15$$
$\left\lceil\quad\right\rceil$は切り上げをする関数 ceiling function(天井関数)

なので,$k$=7のとき$h$=15,$k$=15のとき$h$=7になります.

この# of bins $k$とbin width $h$は data をよく眺めて直接決めてもいいのですが,実はこれらの適切な値についてはこれまでかなり研究されており,"choice","rule","formula"などと呼ばれる方法が知られています.# of data(データの数)$n$を基準にしたもの,SD=standard deviation(標準偏差)$\sigma$,IQR=interquartile range(四分位範囲)を使うものなどいろいろありますが,その中で$n$を基準にして$k$を求めるものは次の3つがあります.

① Square-root choice$$\displaystyle k=\lceil {\sqrt {n}}\rceil\displaystyle $$② Rice Rule(1944年)$$\displaystyle k=\lceil 2\sqrt[3]{n}\rceil \displaystyle$$
③ Sturges' formula(1926年)$$\displaystyle k=\lceil \log _{2}n\rceil +1$$$n$=27を代入すると,いずれも$k$=6になりますから,# of data $n$=27のときは # of bins $k$=6が適切ということになります.

①②③のグラフ

また,# of data $n$とSD=$\sigma$を使って$h$を求めるものに次式があります.

④ Scott’s Rule(1979年)$$\displaystyle h = \left\lceil\frac{3.49\sigma}{\sqrt[{3}]{n}}\right\rceil$$上の例の$\sigma$=20.7なので,$$\displaystyle h=\left\lceil\frac{3.49\times 20.7}{\sqrt[3]{27}}\right\rceil=\left\lceil24.08....\right\rceil=25$$となり,bin width $h$=25,# of bins $k$=4が適切ということになります.

[余談]

Excel で frequency distribution table を作るときに frequency を求める,すなわち多数のデータの中から各 bin width(階級の幅)の度数を数える方法は,「データ分析」「FREQUENCY関数」などを使うより「COUNTIFS関数」を使う方が比較的容易にできました.例えば,ある条件範囲から0以上10以下の数を数えるには次のように入力します.
=COUNTIFS (条件範囲, ">=0", 条件範囲, "<10")

●Excel で histogram と frequency distribution polygon(度数分布多角形)を重ねて描く方法をいろいろ試してみたところ,「挿入→ヒストグラム」「データ分析→ヒストグラム」から描くよりも次の方法が比較的容易でした.
1) グラフを描く準備として,上図のような3列(一番左の列はセルの書式設定で文字列にしておく)を作る.
2) その3列を選択
3) 挿入→おすすめグラフ→すべてのグラフ→組み合わせ→集合縦棒と折れ線→OK(棒グラフと折れ線グラフができる)
4) グラフの縦棒の上で右クリック→データ系列の書式設定→要素の間隔→0%(棒グラフがヒストグラムに変わる)→色を変える

●Excel で frequency distribution table を作る前の生データから histogram だけを作るときは「挿入→ヒストグラム」が楽です.Binの幅が自動的に決まって描かれますが,横軸部分を右クリックし、メニューから「軸の書式設定」を選択して,ビンの幅,ビンのオーバーフロウ,ビンのアンダーフロウを適切に決めればOKです.

[Reference]

Jul 7, 2016

Stars and Bars Method

直訳すると「星と棒の方法」となりますが,combination with repetition(重複組合せ)の問題,別名multichoose problemまたはstars and bars problemと呼ばれる問題を解く方法です.

例えばりんご,みかん,バナナの3種類が多数ある中から4個を選ぶとします.すると(りんご、みかん、バナナ)の数の組合せは、
①全種類から少なくとも一つは選ぶ場合
(1,1,2),(1,2,1),(2,1,1)
の3通りあります.
②選ばない種類があってもいい場合
(0,0,4),(0,1,3),(0,2,2),(0,3,1),(0,4,0),
(1,0,3),(1,1,2),(1,2,1),(1,3,0),
(2,0,2),(2,1,1),(2,2,0),
(3,0,1),(3,1,0),
(4,0,0)
の15通りと急に多くなります.

種類や選ぶ個数が多くなったらどうするか.ここでstars and bars methodを使います.n種類のものが多数ある中からr個を選ぶとしましょう.

②の場合から先に考えます.これは,r個の★とn-1個の仕切り|(たて棒)を一列に並べる場合の数,すなわち「2種類の同じものを含む順列」n+r-1Cr=n+r-1Cn-1と同じになります.例えば上の②の場合のいくつかをstars and barsで表すと次のようになります。
(0,0,4)=||★★★★
(1,0,3)=★||★★★
(1,1,2)=★|★|★★
(4,0,0)=★★★★||
2本の仕切りの左側がりんご,間がみかん,右側がバナナと決めておけば,すべて同じ★で表してもいいわけです.n+r-1Crは簡単にnHrと表します.この場合はn=3,r=4なので,3H4=3+4-1C4=6C4=6C2=15と計算できます.

日本の参考書等では★の代わりに○がよく使われていますから,circles and barsといってもいいかも知れません.

①の場合は,まず各種類から1個ずつ選んでおいて,残りのr-n個を②の場合と同様に考えます.すなわち,nHr-n=3H4-3=3H1=3C1=3で求められます.

以上をまとめると,
①全種類から少なくとも一つは選ぶ場合
nHr-n
②選ばない種類があってもいい場合
nHr=n+r-1Cr=n+r-1Cn-1

さて上の果物の問題は,方程式x+y+z=4の整数解の組の個数を求める問題といえます.
①は正の整数解の組の個数を求める場合で,(x,y,z)の組合せは3H4-3=3通りです.
②は負でない整数解の組の個数を求める場合で,(x,y,z)の組合せは3H4=15通りです.
これらの数の組をmultiset(多重集合)といいます.

②の場合,nHrと表しますが,binomial coefficient(二項係数)nCrを$\binom{n}{r}$と書くときは,nHrを$\left(\!\binom{n}{r}\!\right)$と書きます.以上をまとめて式で表すと次のようになります.$$ _n H_r =\left(\!\binom{n}{r}\!\right)= _{n+r-1} C_r=\binom{n+r-1}{r}=\left( n-1, r \right)!=\frac{(n+r-1)!}{(n-1)!r!}$$途中の式$\left( n-1, r \right)!$は,multinomial coefficient(多項係数)の2項の場合の表し方で,多項係数の場合は次の式になります.$$\left(n_{1},n_{2},\cdot\cdot\cdot,n_{k}\right)!=\frac{(n_{1}+n_{2}+\cdot\cdot\cdot+n_{k})!}{n_{1}!n_{2}!\cdot\cdot\cdot n_{k}!}$$
因みに,次数が等しい項だけでできている多項式をhomogeneous polynomial(同次多項式または斉次多項式)といい、このlike term(同類項)の種類の数が重複組合せになります.nHrのHはこのhomogeneousの頭文字から来ています.
(例)x,y,zでできる4次の項
(0,0,4)=||★★★★→z4
(1,0,3)=★||★★★→xz3
(1,1,2)=★|★|★★→xyz2
(4,0,0)=★★★★||→x4

<Reference>
Multichoose
http://mathworld.wolfram.com/Multichoose.html